Parte II Introducción a la inferencia estadística
La incertidumbre es la falta de conocimiento completo de lo que es o lo que puede ser.
Debido a la incertidumbre, no sabemos las consecuencias después de tomar nuestras acciones. Esta se cuantifica mediante la probabilidad y, en concreto, usaremos variables aleatorias para representar los resultados de los experimentos aleatorios (con incertidumbre).
La forma de trabajar con los modelos probabilisticos es un caso de razonamiento deductivo: se establecen hipotesis respecto al mecanismo generador de los datos y con ellas se deducen las probabilidades de los valores posibles.
Sin embargo, la inferencia estadistica consiste en, una vez observados los datos correspondientes a un experimento, inferir el modelo que ha generado los datos o alguna caracteristica suya, como la media o varianza (razonamiento inductivo).
Los metodos de inferencia estadistica pueden clasificarse por el objetivo del estudio, por el metodo utilizado y pro el tratamiento aleatorio de las cantidades involucradas.
-
Respecto al objetivo del estudio: muestreo frente a diseño.
-
•
Cuando el objetivo es describir una variable o las relaciones entre un conjunto de ellas, se utilizan técnicas de muestreo, que consisten en observar una muestra de la población.
-
•
Cuando el objetivo es contrastar relaciones entre las variables o predecir sus valores futuros se utilizan técnicas de diseño de experimentos, que consisten en fijar los valores de ciertas variables y medir la respuesta que inducen en otras.
-
•
-
Respecto al metodo utilizado: metodos parametricos frente a no parametricos.
-
•
Los métodos paramétricos suponen que los datos muestreados provienen de una variable aleatoria que puede describirse con pocos parámetros. Para ello asumen la forma de una distribucion (normal, Poisson, exponencial, …), y deducen procedimientos óptimos para estimar sus parámetros.
-
•
Los métodos no paramétricos asumen aspectos muy generales sobre la distribución de la variable aleatoria (continua, simétrica, etc.), y tratan de estimar su forma.
-
•
-
Respecto al tratamiento aleatorio de las cantidades involucradas: enfoque clasico frente a enfoque bayesiano.
-
•
El enfoque clásico supone que los parámetros de las distribuciones , son cantidades fijas y desconocidas, sobre las que no se posee información inicial. Por tanto, la inferencia trata a estos parámetros como fijos y no asume ningún tipo de incertidumbre, vía modelos de probabilidad a la hora de aprender sobre ellos (es decir, estimarlos).
- •
-
•
Por otro lado, el enfoque bayesiano considera los parámetros del modelo como cantidades desconocidas, y por tanto los representa mediante variables aleatorias. De esta forma es posible realizar inferencia a través de probabilidades condicionadas, usando el Teorema de Bayes. Además, la inferencia aparecerá resumida mediante una distribución de probabilidad. Otra ventaja de este método es que si se dispone de información inicial, es posible su incorporación en el procedimiento de inferencia.
-
•
Supongamos que queremos investigar la prevalencia de una enfermedad en una ciudad. Se ha considerado una muestra de 20 individuos para verificar si estan infectados.
Nos interesa estimar , la proporcion de individuos infectados en la ciudad. . Los datos observados corresponden a la realizacion de una variable aleatoria que representa el numero de personas con la enfermedad, i.e., .
Un modelo razonable es .
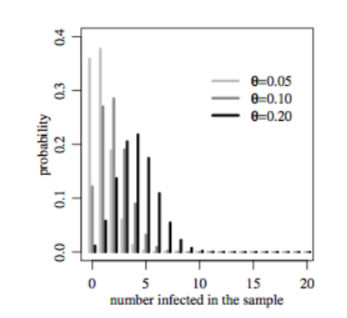
En un analisis Bayesiano, los parametros desconocidos como tambien son variables aleatorias, y por tanto se modeliza la incertidumbre asociada al mismo mediante una distribucion de probabilidad.
En nuestro caso, varios estudios indican que la proporcion de infectados oscila entre y , con un valor esperado alrededor de . Por tanto, podemos representarlo con una distribucion de probabilidad para , , que asigne una cantidad grande de probabilidad al intervalo , y cuyo valor esperado este en torno a .
Para este tipo de modelos, el binomial, la familia de distribuciones de probabilidad que hacen los calculos matematicamente tratables es la familia de distribuciones beta. Existen varias formas posibles para la funcion de densidad beta:
Se verifica que
En nuestro problema, vamos a representar la incertidumbre inicial sobre con una . Para esta distribucion tenemos que
Si tenemos un modelo para los datos,
y sobre , entonces los calculos tras usar el teorema de Bayes nos dan como resultado una distribucion final para :
donde representa el numero de casos infecciosos observados en la muestra.
Supongamos por ejemplo que el numero de individuos infectados es , es decir, . La distribucion a posteriori o final es una , .
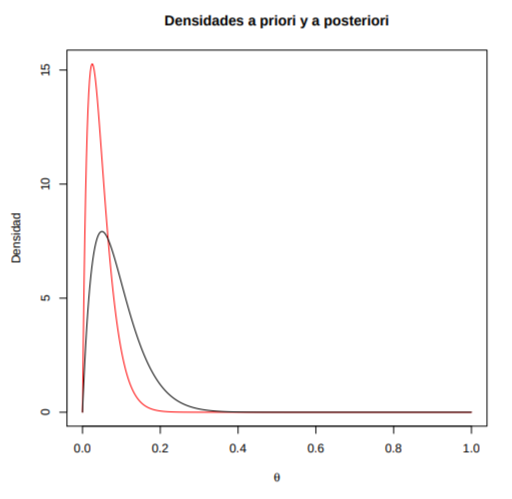
La distribución final nos proporciona una herramienta para aprender acerca de la proporción teórica de infectados, por ejemplo podemos proporcionar la media o moda de esta distribución como resumen de la misma.
O también podemos decir como resumen que con un de probabilidad pensamos que la proporción de infectados está por debajo del .