1 Estadistica descriptiva
La estadistica descriptiva es la ciencia que estudia como debe emplearse la informacion y como dar una guia de accion en situaciones practicas que entrañan incertidumbre.
Se ocupa de la recopilacion, organizacion y resumen de los datos, con el fin de extraer informacion de los mismos. En el comienzo de cualquier estudio se debe saber que es lo que se desea medir o investigar y para que. Una correcta seleccion de datos preliminares ahorrara tiempo y coste en un estudio.
Las fases de un estudio cuantitativo son las siguientes:
-
1.
Planteamiento del problema: definir el objetivo de la investigacion y precisar la poblacion a la que se refiere.
-
2.
Recogida de la informacion:
-
Exhaustiva (toda la poblacion).
-
Muestreo (una parte representativa de la poblacion).
-
Diseño de los experimentos (hacer una recogida adecuada de los datos).
-
-
3.
Depuracion de los datos
-
4.
Analisis descriptivo de los datos
-
5.
Conclusiones
1.1 Conceptos basicos
El conjunto de individuos o unidades estadisticas de observacion sobre los que se va a realizar el estudio.
Un censo es una relacion exhaustiva de los individuos de la poblacion.
Cuando no es posible analizar toda la poblacion, se puede tomar un subconjunto de elementos de la poblacion, que se denomina muestra.
Si se quiere hacer inferencias sobre la poblacion a partir de la muestra, debe ser representativa, de tamaño minimo y debe haber sido seleccionada de forma aleatoria.
Distinguimos los siguientes elementos:
-
Individuo o unidad de analisis: objeto bajo estudio.
-
Variable: cualquier caracteristica de la unidad de observacion que interese registrar.
-
Valor de una variable, dato, observacion u medicion: numero o codigo que describe a la caracteristica de interes en una unidad particular.
-
Caso o registro: conjunto de mediciones realizadas sobre un individuo.
Las variables pueden clasificarse en dos grandes tipos: cuantitativas y cualitativas.
Las variables cuantitativas son aquellas cuyos valores se pueden expresar en cantidades numericas. A su vez se clasifican en discretas, si toman valores en un conjunto numerable de valores, o continuas, si el conjunto es no numerable.
Las variables cualitativas son aquellas que solo se pueden clasificar y no medir. Se miden en escala nominal u ordinal.
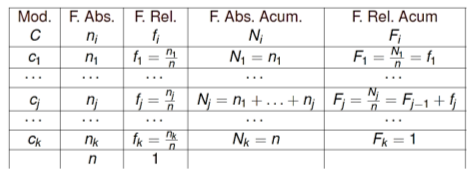
Sea una poblacion estadistica de individuos o registros, descrita segun un caracter o variable , cuyas modalidades han sido agrupadas en un numero de clases o categorias, que denotamos mediante . La tabla de frecuencia consiste en lo siguiente:
Se ha medido la siguiente caracteristica: EDAD en una muestra de 30 individuos. Los resultados obtenidos son:
La tabla de frecuencia es la siguiente
| Valor | Frec. absoluta | Frec. relativa |
| Total |
La media representa el centro de gravedad de los datos. Se calcula solo para variables cuantitativas. Su calculo depende de como se presenten los datos:
-
no agrupados:
-
discretos y agrupados:
-
continuos y agrupados:
La moda es el valor que mas se repite. Se utiliza al analizar variables cualitativas.
La mediana es el valor tal que, ordenados los datos de forma creciente o decreciente, deja a cada uno de sus lados la mitad de las observaciones.
Si los datos no estan agrupados, es la observacion que ocupa la posicion si es impar, o a la semisuma de los valores que ocupan las posiciones y si es par.
Para datos agrupados en tabla, sera el primer valor cuya frecuencia acumulada sea mayor o igual a
Si la variable es de tipo continua y los datos estan agrupados, la mediana es una aproximacion. Es una medida robusta.
El percentil de orden , con , es el valor de los datos que deja a su izquierda el de los datos de la muestra.
La mediana es el percentil , y se suele trabajar con los cuartiles , , .
Las medidas de centralizacion indican cuanto varian los datos:
-
Desviación Media ( grupos) .
-
Varianza .
-
Desviación estándar .
-
Cuasi-varianza
-
Cuasi-desviación estándar
-
Rango
-
Rango intercuartílico
Para comparar la dispersion, se utiliza el coeficiente de variacion .
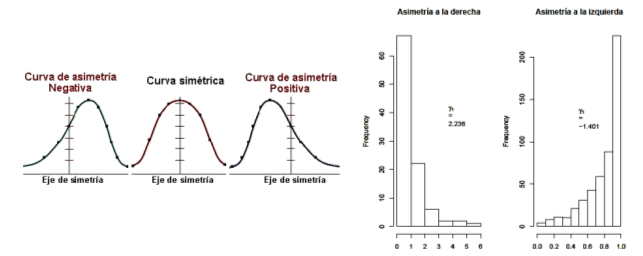
La medida de asimetria toma como referencia la distribucion normal, y se calcula como
siendo la distribucion asimetrica positiva o hacia la derecha si el valor es positivo y hacia la izquierda si es negativo.
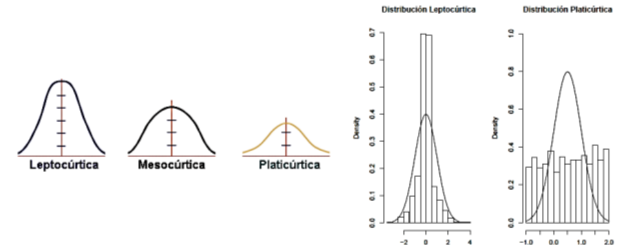
El coeficiente de curtosis tambien toma como referencia la distribucion normal, y se calcula como
siendo la distribucion mas apuntalada si el valor es positivo y menos si es negativo.
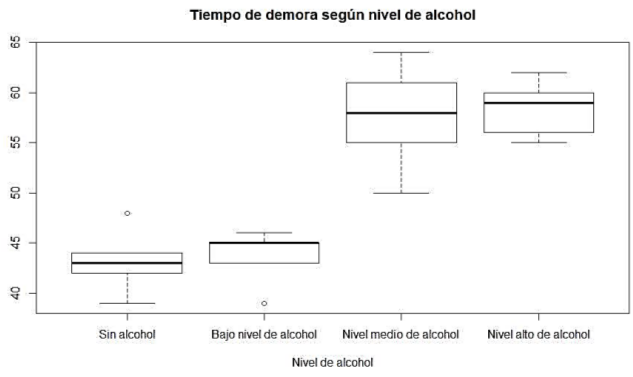
Los box plots se basan en los estadisticos de orden minimo, maximo, mediana y cuartiles. Muestran cinco medidas de posicion, permiten estudiar la simetria de los datos y dan un criterio de deteccion de datos atipicos. A continuacion se muestra un ejemplo:
1.2 Analisis bivariante
Los datos bivariantes proceden de la observacion simultanea de dos variables, que podemos llamar e , en una poblacion de individuos. Este tipo de datos son pares de la forma .
Para describirlo, se analiza el comportamiento de cada variable por separado, se describe el comportamiento conjunto de las dos variables y se explora el tipo de relacion que existe entre ellas. Ademas, se puede representar la distribucion con una tabla de doble entrada, de forma que cada celda contiene la frecuencia absoluta conjunta de ambas variables.
1.2.1 Asociación lineal
Consideremos dos magnitudes e , de las que tenemos datos .
Una medida de la variación conjunta de e se llama covarianza, se designa por y viene definida por:
El hecho de que la medida de covarianza dependa de la unidad de medida de las variables, lleva a utilizar una nueva medida de asociacion lineal adimensional. Existen indices de asociacion lineal para este caso, llamados correlacion de Pearson y correlacion de Spearman:
Si es cercano a hay asociacion lineal directa entre e . Si es cercano a , hay asociacion lineal inversa entre e y . Por ultimo, si es cercano a , no hay asociacion entre e .
1.2.2 Regresión lineal
Si queremos cuantificar dicha relacion, necesitamos conocer la relacion funcional entre la variable dependiente y la variable independiente . Para ello, usamos la regresion.
En el caso mas sencillo, cuando la relacion es lineal, el problema consiste en calcular la recta que mejor se ajuste a los datos.
Los parametros y se calculan imponiendo la condicion de que la suma de los cuadrados de las distancias de los puntos a la recta debe ser minima, es decir, se minimiza
donde es el valor observado e el valor estimado. A la diferencia se le llama residuo.
Por tanto, es necesario resolver el siguiente sistema de ecuaciones:
y se obtiene la solucion
Asi, podemos expresar la recta de regresion lineal simple como
El coeficiente de determinacion, denominado , mide que porcentaje de la variacion de una variable dependiente se puede explicar por el modelo estadistico. Para definir su valor, partimos de la siguiente igualdad (descomposicion de la varianza):
Cuanto mas parecidas sean y mejor sera la estimacion, pues en ese caso la mayor parte de la variabilidad de vendria explicada por la regresion realizada.
La expresion de es:
Cabe destacar que este valor solo mide la bondad del ajuste lineal, pero puede existir otro tipo de dependencia.
Un modelo de regresion lineal supone las siguientes condiciones, que deben verificarse previamente:
-
Los residuos son normales de media y varianza comun desconocida . Ademas, estos residuos son independientes.
-
El numero de variables explicativas () es menor que el de observaciones .
-
No existen relaciones lineales exactas entre las variables explicativas.